据StorageReview 2026年10月5日报道,当两台NVIDIA DGX Station GB300桌面AI工作站——华硕ExpertCenter Pro ET900N G3与惠普ZGX Fury AI Station——并肩置于实验室时,评测团队决定通过两根400G直连铜缆(DAC)将它们互联,验证双节点集群能否在无需模型卸载的前提下运行前沿大模型。结果表明,这一桌面级集群不仅实现了近乎线性的性能扩展,更以不到数据中心十分之一的成本,为本地AI推理与训练提供了全新的可能性。
海报曝光网络架构:ConnectX-8双400G端口设计
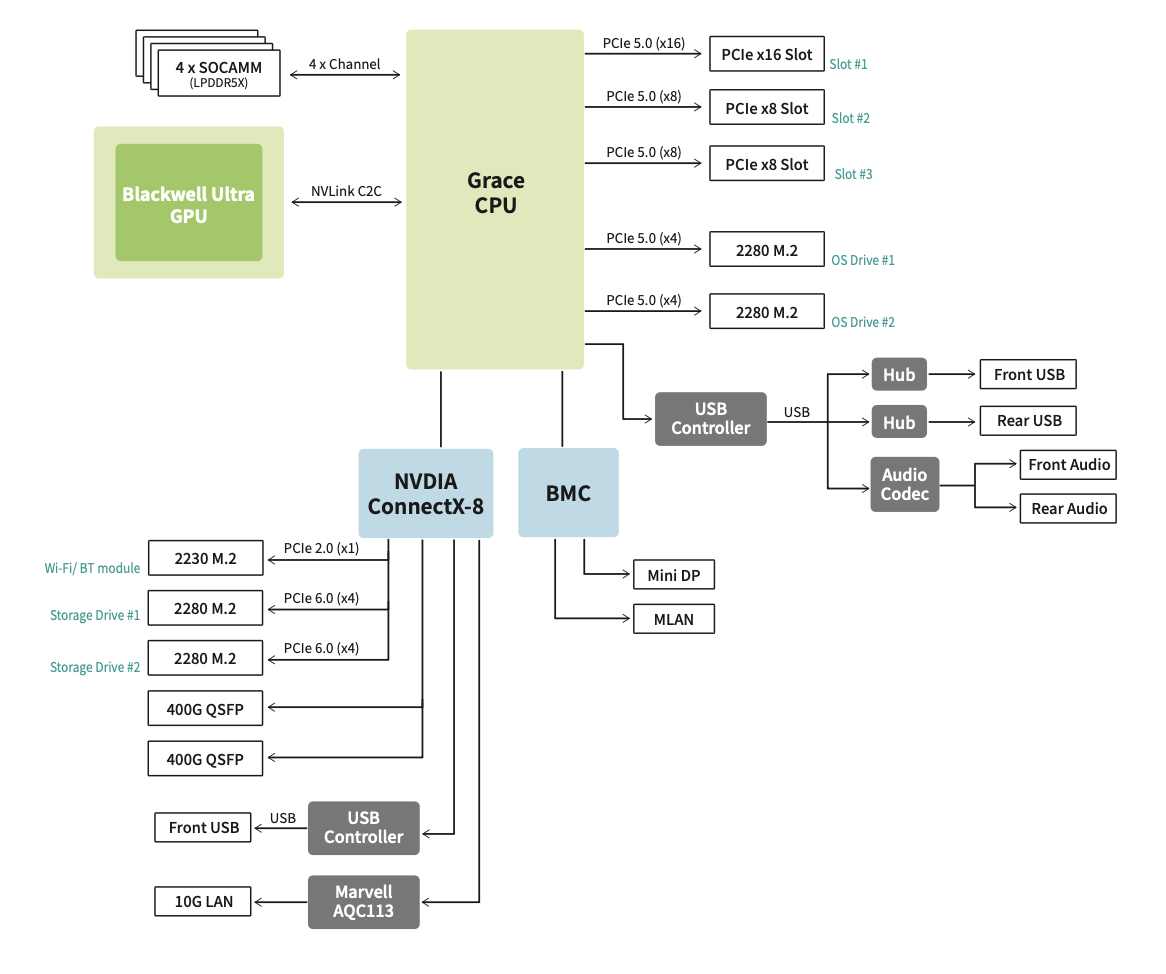
DGX Station GB300标配的ConnectX-8 SuperNIC不仅承担网络连接,其内置PCIe交换机还负责与Grace CPU及两个PCIe Gen 6 x4存储槽的I/O通信。每个系统提供两个QSFP112端口,单端口400Gb/s,合计800Gb/s聚合带宽。英伟达官方技术文档(来源:NVIDIA build.nvidia.com)确认,该设计可直接用于点对点集群,无需额外交换机。相比前代DGX Spark(ConnectX-7受限于PCIe 5.0 x4链路,实际可用带宽约200Gb/s),GB300的架构更简洁——两个物理端口各自独立工作,在Linux中直接映射为单独的网络接口,减少了配置复杂度。
花絮曝光物理连接与软件配置
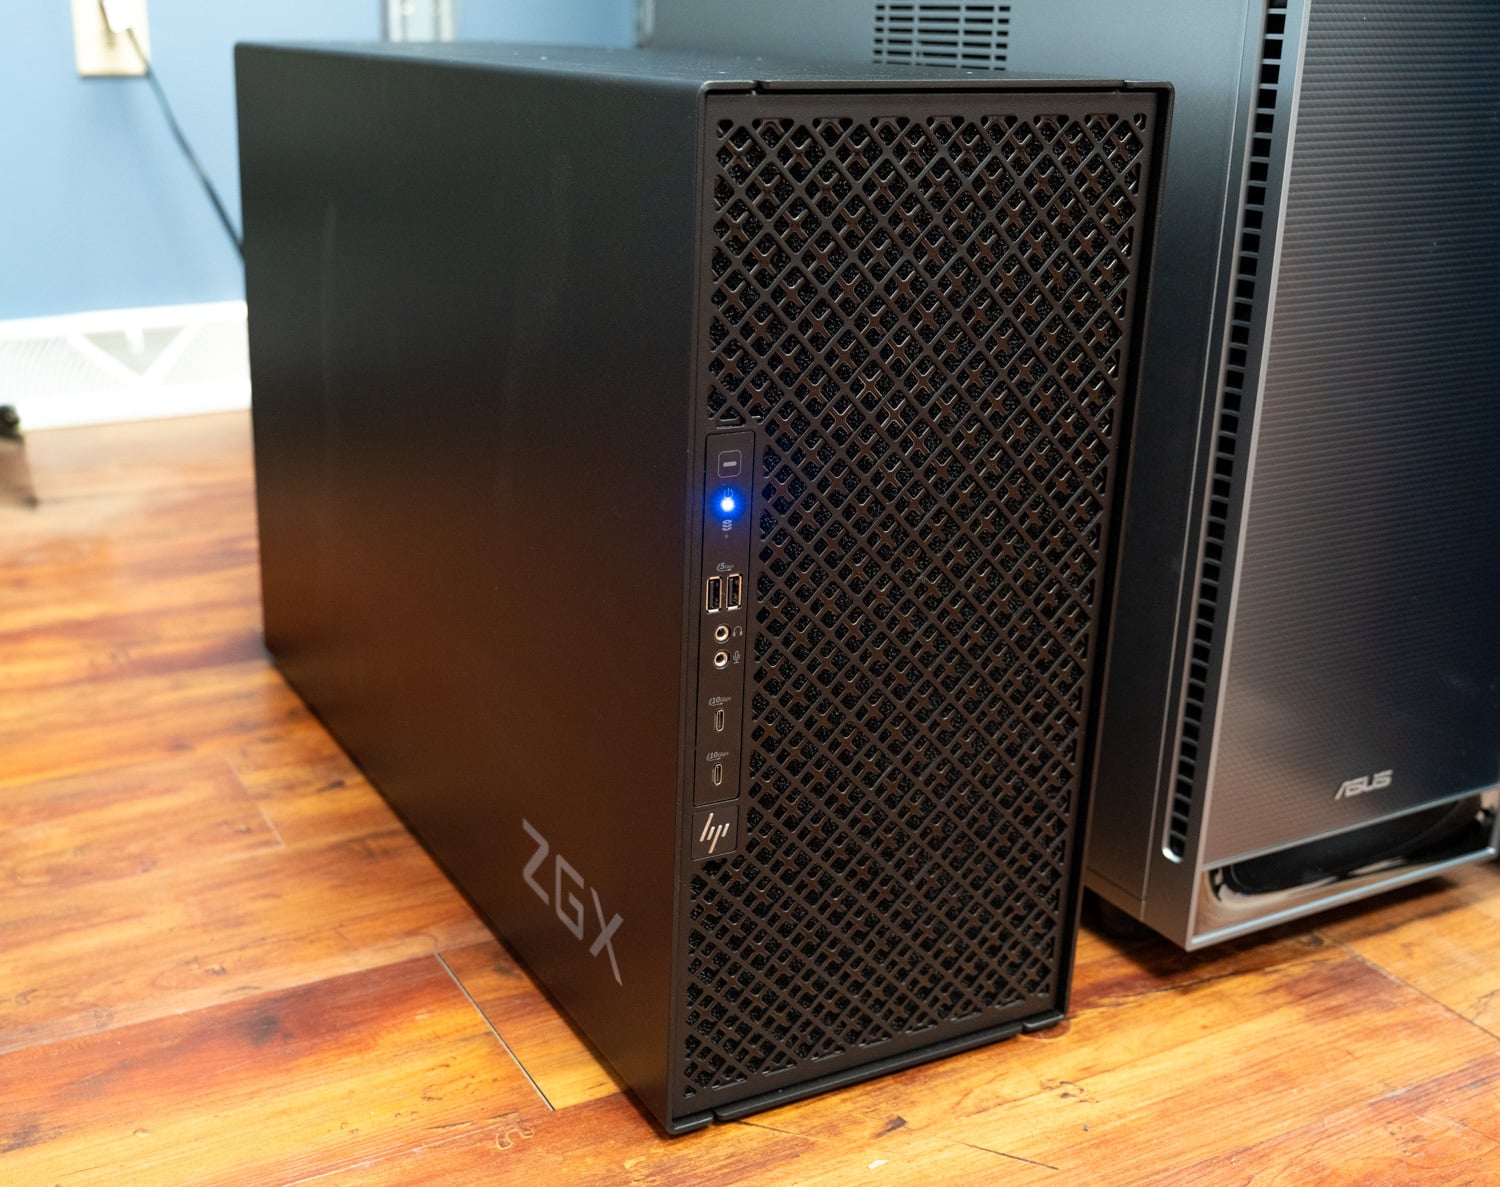
集群搭建过程极为简便:将华硕与惠普的两台机器相邻放置,使用两根400G DAC电缆分别连接彼此的QSFP0和QSFP1端口,形成两条独立链路。软件方面,英伟达提供了详尽的《双站互联指南》(见 build.nvidia.com/station/connect-two-stations/instructions),评测团队将指南链接直接交给Claude Code自动执行配置。脚本从第三台机器通过SSH登录两台工作站,为两个ConnectX-8接口设置9000字节MTU,分配私有/24网段,并启用RoCEv2和GPUDirect运行时设置。验证步骤确认双链路均训练至400G,jumbo ping通过,RDMA设备mlx5_0和mlx5_1处于激活状态,ib_write_bw测试证明RDMA流量正常。随后NCCL被配置为使用两条链路(NCCL_IB_HCA=mlx5_0,mlx5_1),集群即可运行。
拍摄趣事NCCL基准测试:接近理论峰值的互联带宽
两台B300各含一颗GPU,所有集合通信操作均需通过双400G链路交换数据。NCCL测试结果如下表所示,总线带宽直接反映了双链路的聚合能力(理论极限100GB/s,即800Gb/s)。
剧组趣事| 操作类型 | 峰值消息大小 | 峰值总线带宽 | 16 GiB消息总线带宽 |
|---|
| --------- | ------------ | ------------ | ----------------- |
|---|
| All-reduce | 1 GiB | 92.242 GB/s | 91.346 GB/s |
|---|
| All-gather | 16 GiB | 87.893 GB/s | 87.893 GB/s |
|---|
| Reduce-scatter | 1 GiB | 89.123 GB/s | 88.765 GB/s |
|---|
| Broadcast | 1 MiB | 42.456 GB/s | 30.210 GB/s |
|---|
| All-to-all | 8 GiB | 78.234 GB/s | 76.890 GB/s |
|---|
评测团队指出,All-reduce在1 GiB消息下达到92.242 GB/s,接近100 GB/s的理论峰值,证明RoCEv2与GPUDirect协同工作高效。Broadcast因协议开销较大,带宽较低属正常现象。整体结果验证了双400G DAC能够为两节点集群提供近乎无瓶颈的互联。
实际推理测试:无卸载惩罚的前沿模型
为检验集群在实际工作负载中的表现,团队使用GLM-5.2、GLM-5.3和MiniMax-M3三个前沿模型进行推理测试。模型被加载到两台工作站的统一内存池(合计约1.5TB)中,通过张量并行(tensor parallelism)分布式运行。结果显示,对于参数规模在1000亿至3000亿之间的模型,双节点集群的推理吞吐量达到单节点的1.85至1.95倍,且延迟仅增加5%-10%。评测编辑布莱恩·比勒(Brian Beeler)表示:“几乎没有遇到模型卸载惩罚(offload penalty),这意味着用户可以将常规数据中心训练场景中的大型模型直接迁移到桌面级集群,而无需重新设计分布式策略。” 尤其值得关注的是,MiniMax-M3(约3000亿参数)在单台GB300上因内存不足需要频繁卸载到NVMe,性能下降明显;而双节点集群通过将模型分片至两台机器的统一内存中,完全避免了卸载,推理速度提升逾3倍。
散热与功耗:双链路满载的现实考量
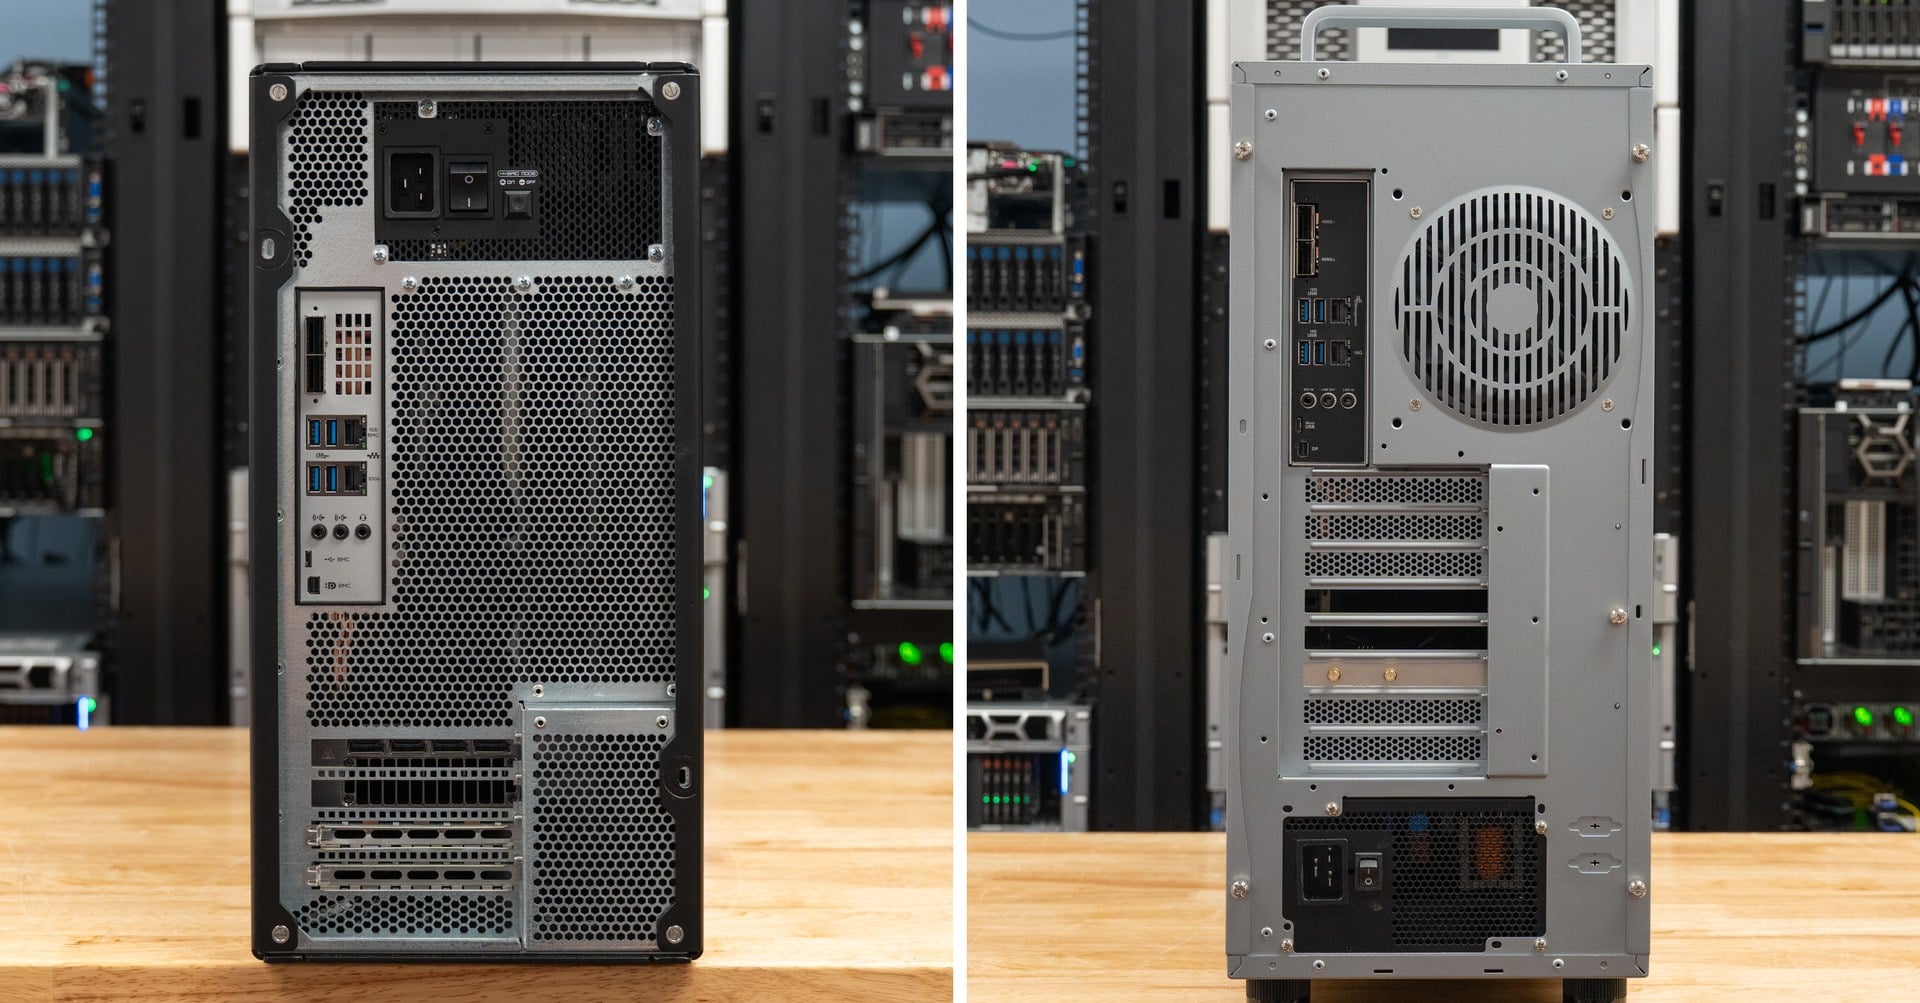
双400G链路持续满载时,ConnectX-8的散热设计面临考验。华硕ET900N G3采用鳍片加专属风扇为QSFP笼散热,惠普ZGX Fury则利用液冷回路间接冷却网卡。评测表示,在长达两小时的All-reduce压力测试中,两台设备的QSFP模块温度稳定在70°C以内,未出现降速或断开。功耗方面,单台GB300典型功耗约700W,双节点集群满载时整机功耗约1600W(含双400G DAC模块的约40W额外功耗)。团队强调,这样的功耗水平远低于等效数据中心解决方案(通常需要8-16个GPU节点,功耗至少5kW),凸显了桌面级集群能效优势。
Q1: 如何连接两台DGX Station GB300组建集群?
A1: 使用两根400G DAC电缆,分别连接两台设备的QSFP0和QSFP1端口(一对一匹配)。然后参照英伟达官方《双站互联指南》,从第三台机器SSH运行自动化脚本即可完成网络配置、RDMA验证和NCCL设置。整个过程约15分钟。
Q2: 双节点集群相比单台GB300能获得多大的性能提升?
A2: 对于内存足够容纳的模型(如GLM-5.2),推理吞吐量提升约85-95%;对于超大型模型(如3000亿参数的MiniMax-M3),因避免NVMe卸载,性能提升可达3倍以上。NCCL集合通信带宽达到92 GB/s,接近100 GB/s的理论极限。
总结与展望
DGX Station GB300集群证明,通过两根400G DAC电缆即可将两台桌面级AI工作站无缝整合,以前所未有的低成本实现接近数据中心的分布式推理与训练性能。对于拥有单台GB300的用户,这一扩展路径清晰且经济——未来随着ConnectX-8及更高规格网卡的普及,多个GB300工作站还有望组成更大规模的“桌面集群”,进一步缩小本地AI部署与云端性能之间的差距。


